
Waldemar Schneider
IT-Systemintegrator, der sowohl die Produktionshalle als auch den Serverraum versteht.
© 2026 Waldemar Schneider
 Portfolio
Monitoring-Stack: Dashboard und Log-Erweiterung
Inhalt
Projektübersicht
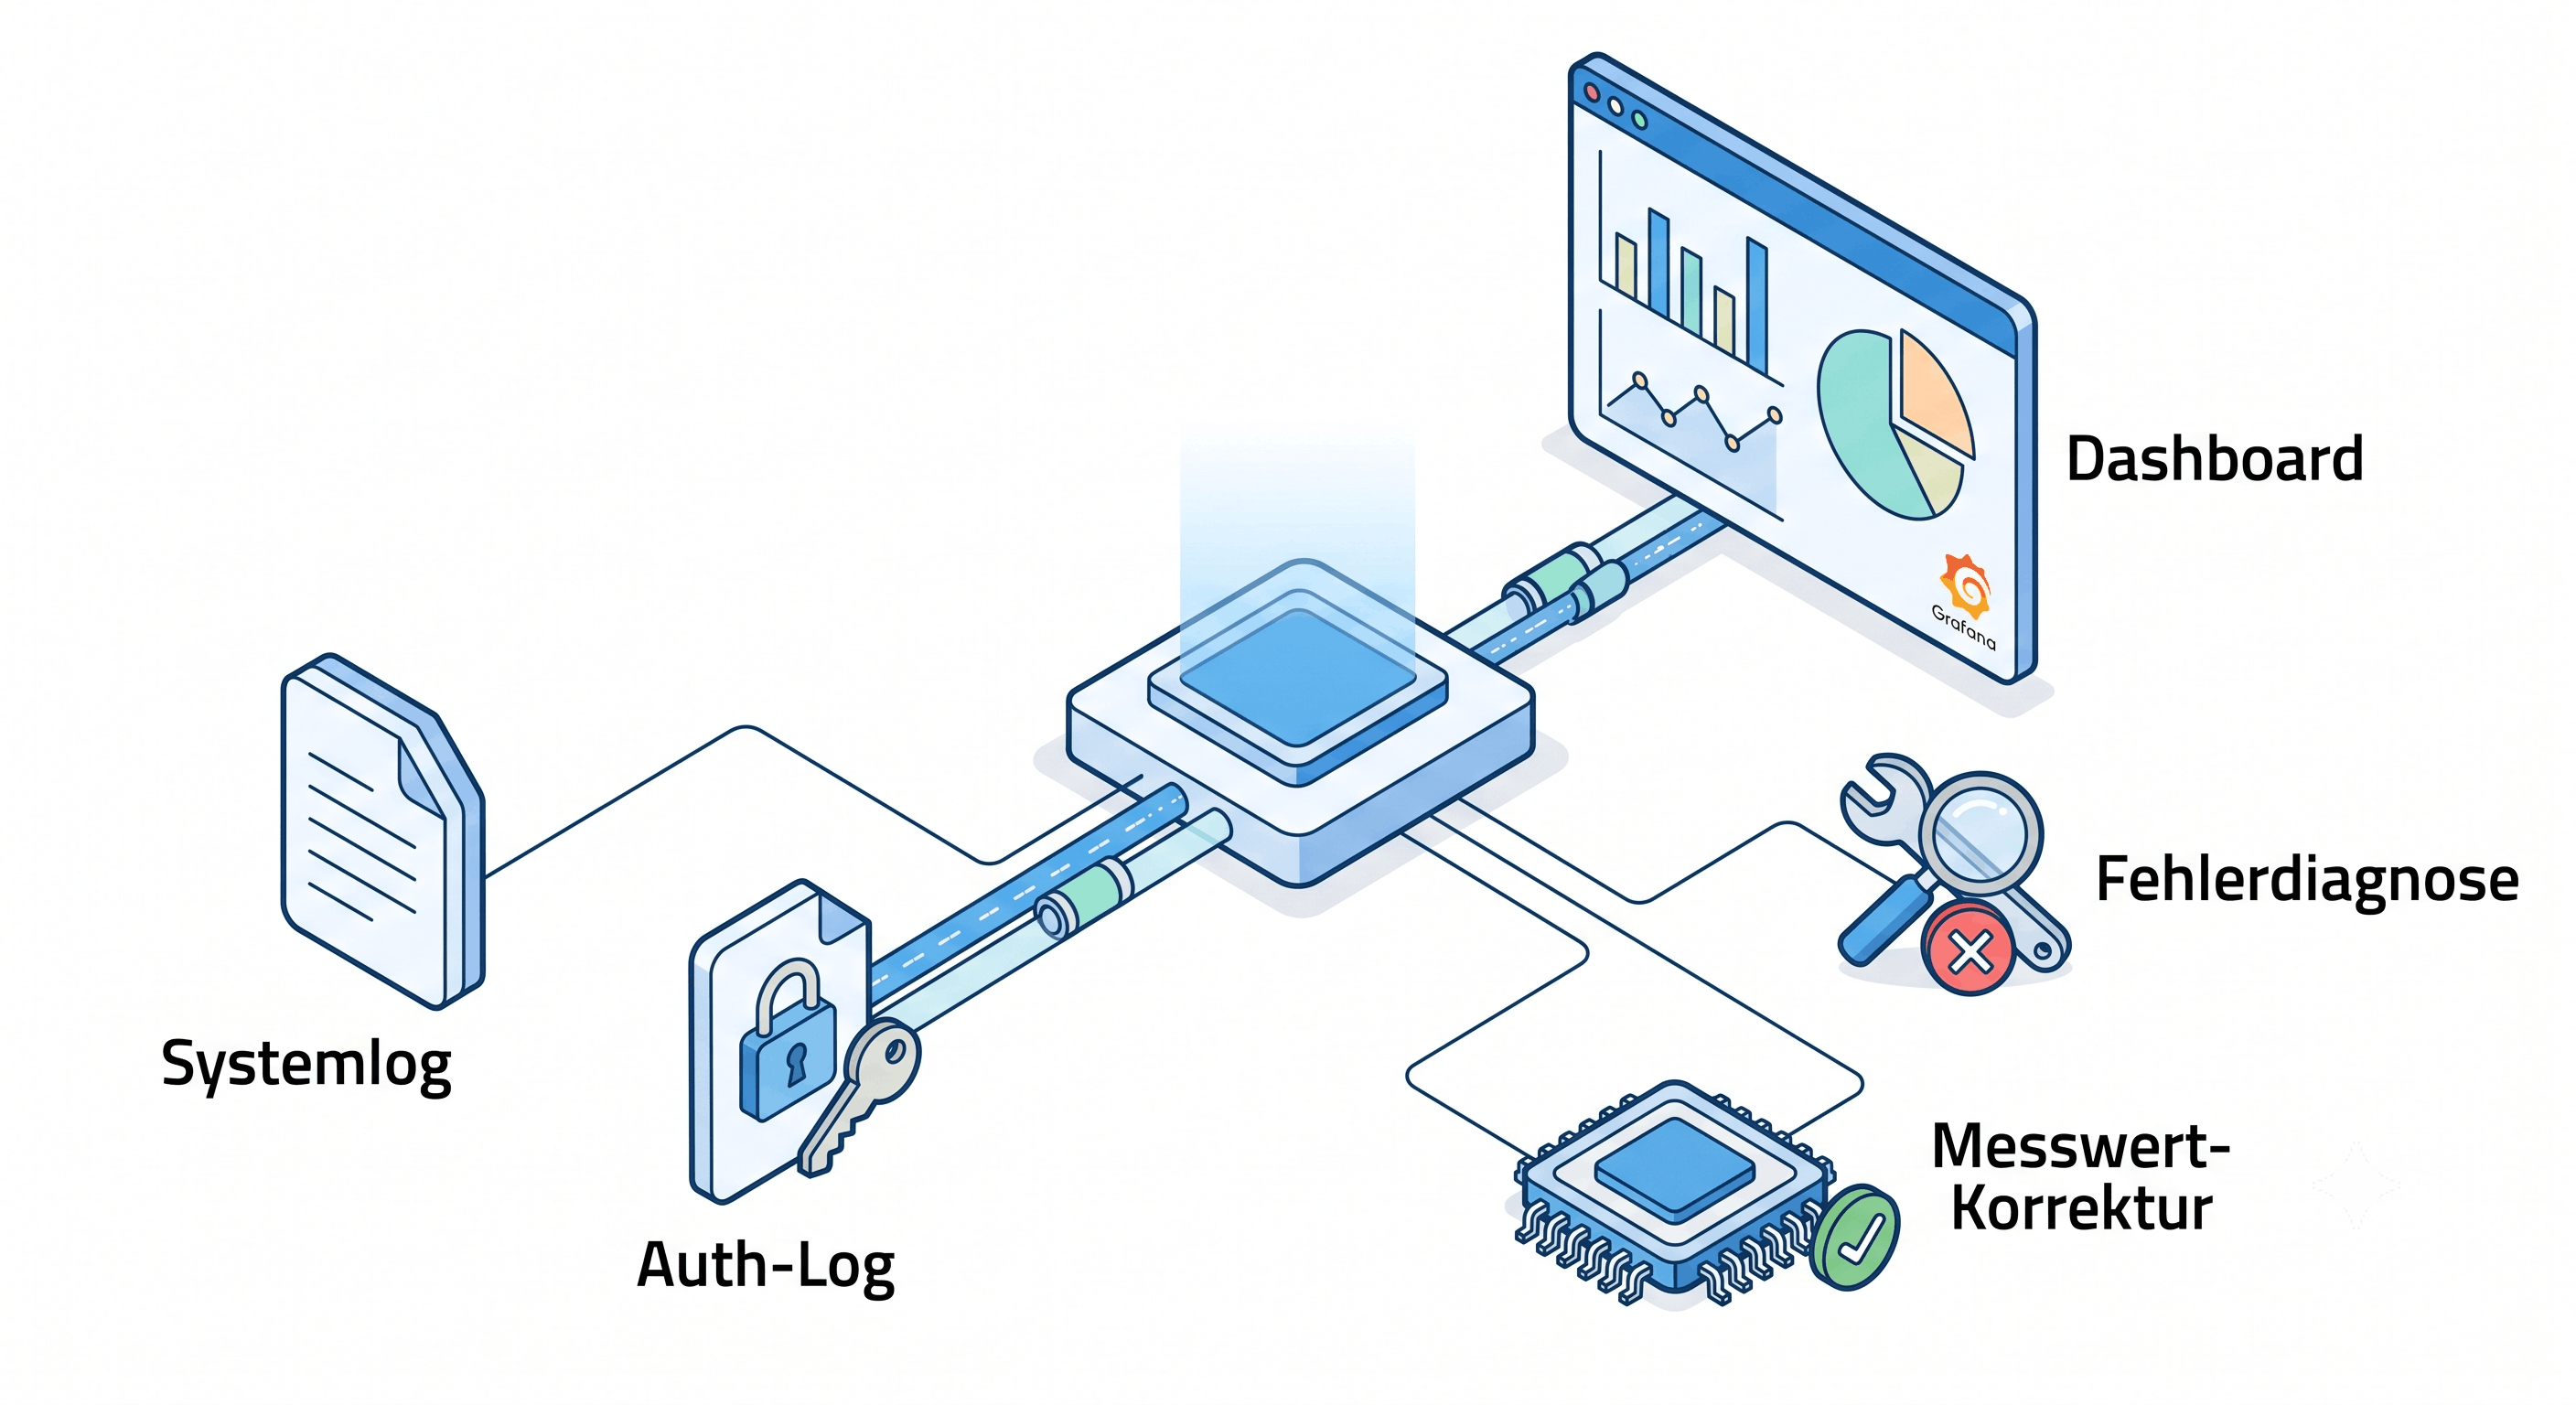
Der bestehende Monitoring-Stack aus Grafana, Prometheus, Loki und Promtail war funktionsfähig, aber noch ohne auswertbare Dashboards oder Sicherheits-Log-Überwachung. In dieser Phase wurde das Dashboard auf dem Linux-System aufgebaut, auth.log als zweite Log-Quelle eingebunden und mehrere kleinere Systemprobleme diagnostiziert und behoben.
1. Situation (Ausgangslage)
Prometheus und Loki sammelten bereits Metriken und Logs, aber es gab kein Dashboard das die Daten auswertbar machte. Promtail überwachte nur das allgemeine Systemlog, nicht die sicherheitsrelevanten Authentifizierungsereignisse. Ausserdem zeigte der Systemstatus zwei dauerhaft fehlgeschlagene Dienste sowie eine unerwartet hohe CPU-Auslastungsanzeige, die sich bei näherer Untersuchung als Messproblem in der virtualisierten Umgebung herausstellte.
2. Task (Zielsetzung)
- Log-Erweiterung: auth.log als zweite Promtail-Quelle einbinden, um SSH-Logins und fehlgeschlagene Authentifizierungsversuche zentral durchsuchbar zu machen.
- Dashboard: Ein vollständiges System-Health-Dashboard in Grafana erstellen mit CPU, RAM, Disk, Netzwerk, Load Average, Uptime, offenem Dateideskriptor-Zahler, Dienst-Status und Log-Panels.
- Systemstabilitat: Fehlgeschlagene Systemd-Units bereinigen und die CPU-Messung fur LXC-Umgebungen korrekt konfigurieren.
3. Action (Umsetzung)
A. Promtail um auth.log erweitern
Die Promtail-Konfiguration wurde um einen zweiten Scrape-Job erganzt, der auth.log einliest. Ausserdem wurde auf beiden Jobs ein host-Label gesetzt. Das ist Vorbereitung fur spatere Multi-Host-Setups: wenn mehrere Systeme Logs an dieselbe Loki-Instanz schicken, muss klar erkennbar sein, von welchem Host ein Eintrag stammt.
auth.log gehort der Gruppe adm und ist fur andere Benutzer nicht lesbar. Da Promtail als eigener Systembenutzer lauft, fehlte die Leseberechtigung. Die Losung war, Promtail mit usermod -a -G adm zur Gruppe adm hinzuzufugen. Das -a-Flag ist dabei wichtig: ohne es wurde usermod alle bestehenden Gruppen des Benutzers ersetzen statt eine neue hinzuzufugen.
B. Systemd-Bereinigung
Zwei Dienste aus dem Debian-Standardimage schlugen beim Start dauerhaft fehl: ein NVMe-over-Fabrics-Dienst und ein IPMI-Dienst. Beide setzen physische Hardware voraus, die in einem virtualisierten LXC-Container nicht vorhanden ist. Mit systemctl mask wurden beide Units dauerhaft deaktiviert. Der Unterschied zu disable: mask setzt einen Symlink auf /dev/null und verhindert damit auch manuelles Starten. Fur Dienste, die in einer Umgebung grundsatzlich keine Funktion haben, ist das die sauberere Losung.
C. CPU-Messung fur LXC korrigieren
Die anfangliche PromQL-Abfrage fur CPU-Auslastung lieferte unrealistisch hohe Werte. Diagnose: Node Exporter sieht in einem LXC-Container mehr CPU-Cores als tatsachlich genutzt werden konnen. Die uberzahligen Phantom-Cores liefern fur alle Zeitwerte null, was den Durchschnittswert verzerrt. Die Losung war ein > 0-Filter in der PromQL-Query, der Cores ohne echte Messwerte dynamisch ausblendet. Das Ergebnis stimmte danach mit der Anzeige in der Proxmox-Oberflache uberein.
D. Grafana-Dashboard aufbauen
Das Dashboard wurde mit 14 Panels aufgebaut, aufgeteilt in Zeitreihengraphen (CPU, RAM, Netzwerk, Load Average), Stat-Panels (RAM absolut, Disk, Uptime, offene Dateideskriptoren, Dienst-Status) und zwei Log-Panels (syslog und auth.log). Schwellwerte wurden fur alle Metriken gesetzt. Alle Werte wurden nach Fertigstellung gegen die jeweiligen Terminal-Ausgaben verifiziert.
4. Result (Ergebnis & Verifikation)
Das Dashboard zeigt alle relevanten Systemmetriken in Echtzeit und wird alle 30 Sekunden aktualisiert. Sieben Kerndienste werden auf Laufzustand uberwacht. Beide Log-Quellen (syslog und auth.log) sind in Loki verfugbar und im Dashboard durchsuchbar.
Zur Verifikation wurden alle Dashboard-Werte mit Terminal-Befehlen abgeglichen: RAM-Belegung per free -h, Disk per df -h, Uptime aus /proc/uptime, offene Dateideskriptoren aus /proc/sys/fs/file-nr. Alle Werte stimmten uberein, kleinere Abweichungen bei CPU und Disk sind auf unterschiedliche Messzeitpunkte und Rundungen zuruckzufuhren. Dass Promtail auth.log tatsachlich liest, wurde mit lsof bestatigt.
Lessons Learned
- LXC und Phantom-Cores: Node Exporter erbt teilweise die CPU-Topologie des Hosts. Wer Monitoring in virtualisierten Umgebungen aufsetzt, sollte die gemessenen Werte immer gegen eine zweite Quelle gegenchecken, bevor er Schwellwerte konfiguriert.
- Dateirechte vor Deployment klaren: Bevor ein Dienst als Log-Quelle eingebunden wird, lohnt es sich, die Berechtigungen der Zieldatei zu prufen. Das spart einen unnotigen Neustart nach der Diagnose.
maskvs.disable: Fur Dienste, die in einer Umgebung strukturell nicht lauffahig sind, istmaskdie richtige Wahl.disablereicht nicht, wenn ein Dienst theoretisch noch manuell gestartet werden konnte.- Metriken brauchen ein Dashboard: Rohdaten in Prometheus und Loki sind wertvoll, aber erst mit einem konfigurierten Dashboard tatsachlich nutzbar im Betrieb. Das Dashboard ist nicht das Ziel, sondern die Voraussetzung fur sinnvolles Monitoring.