
Waldemar Schneider
IT-Systemintegrator, der sowohl die Produktionshalle als auch den Serverraum versteht.
© 2026 Waldemar Schneider
 Portfolio
Monitoring-Stack: Portfolio-Stack anbinden
Inhalt
Projektübersicht
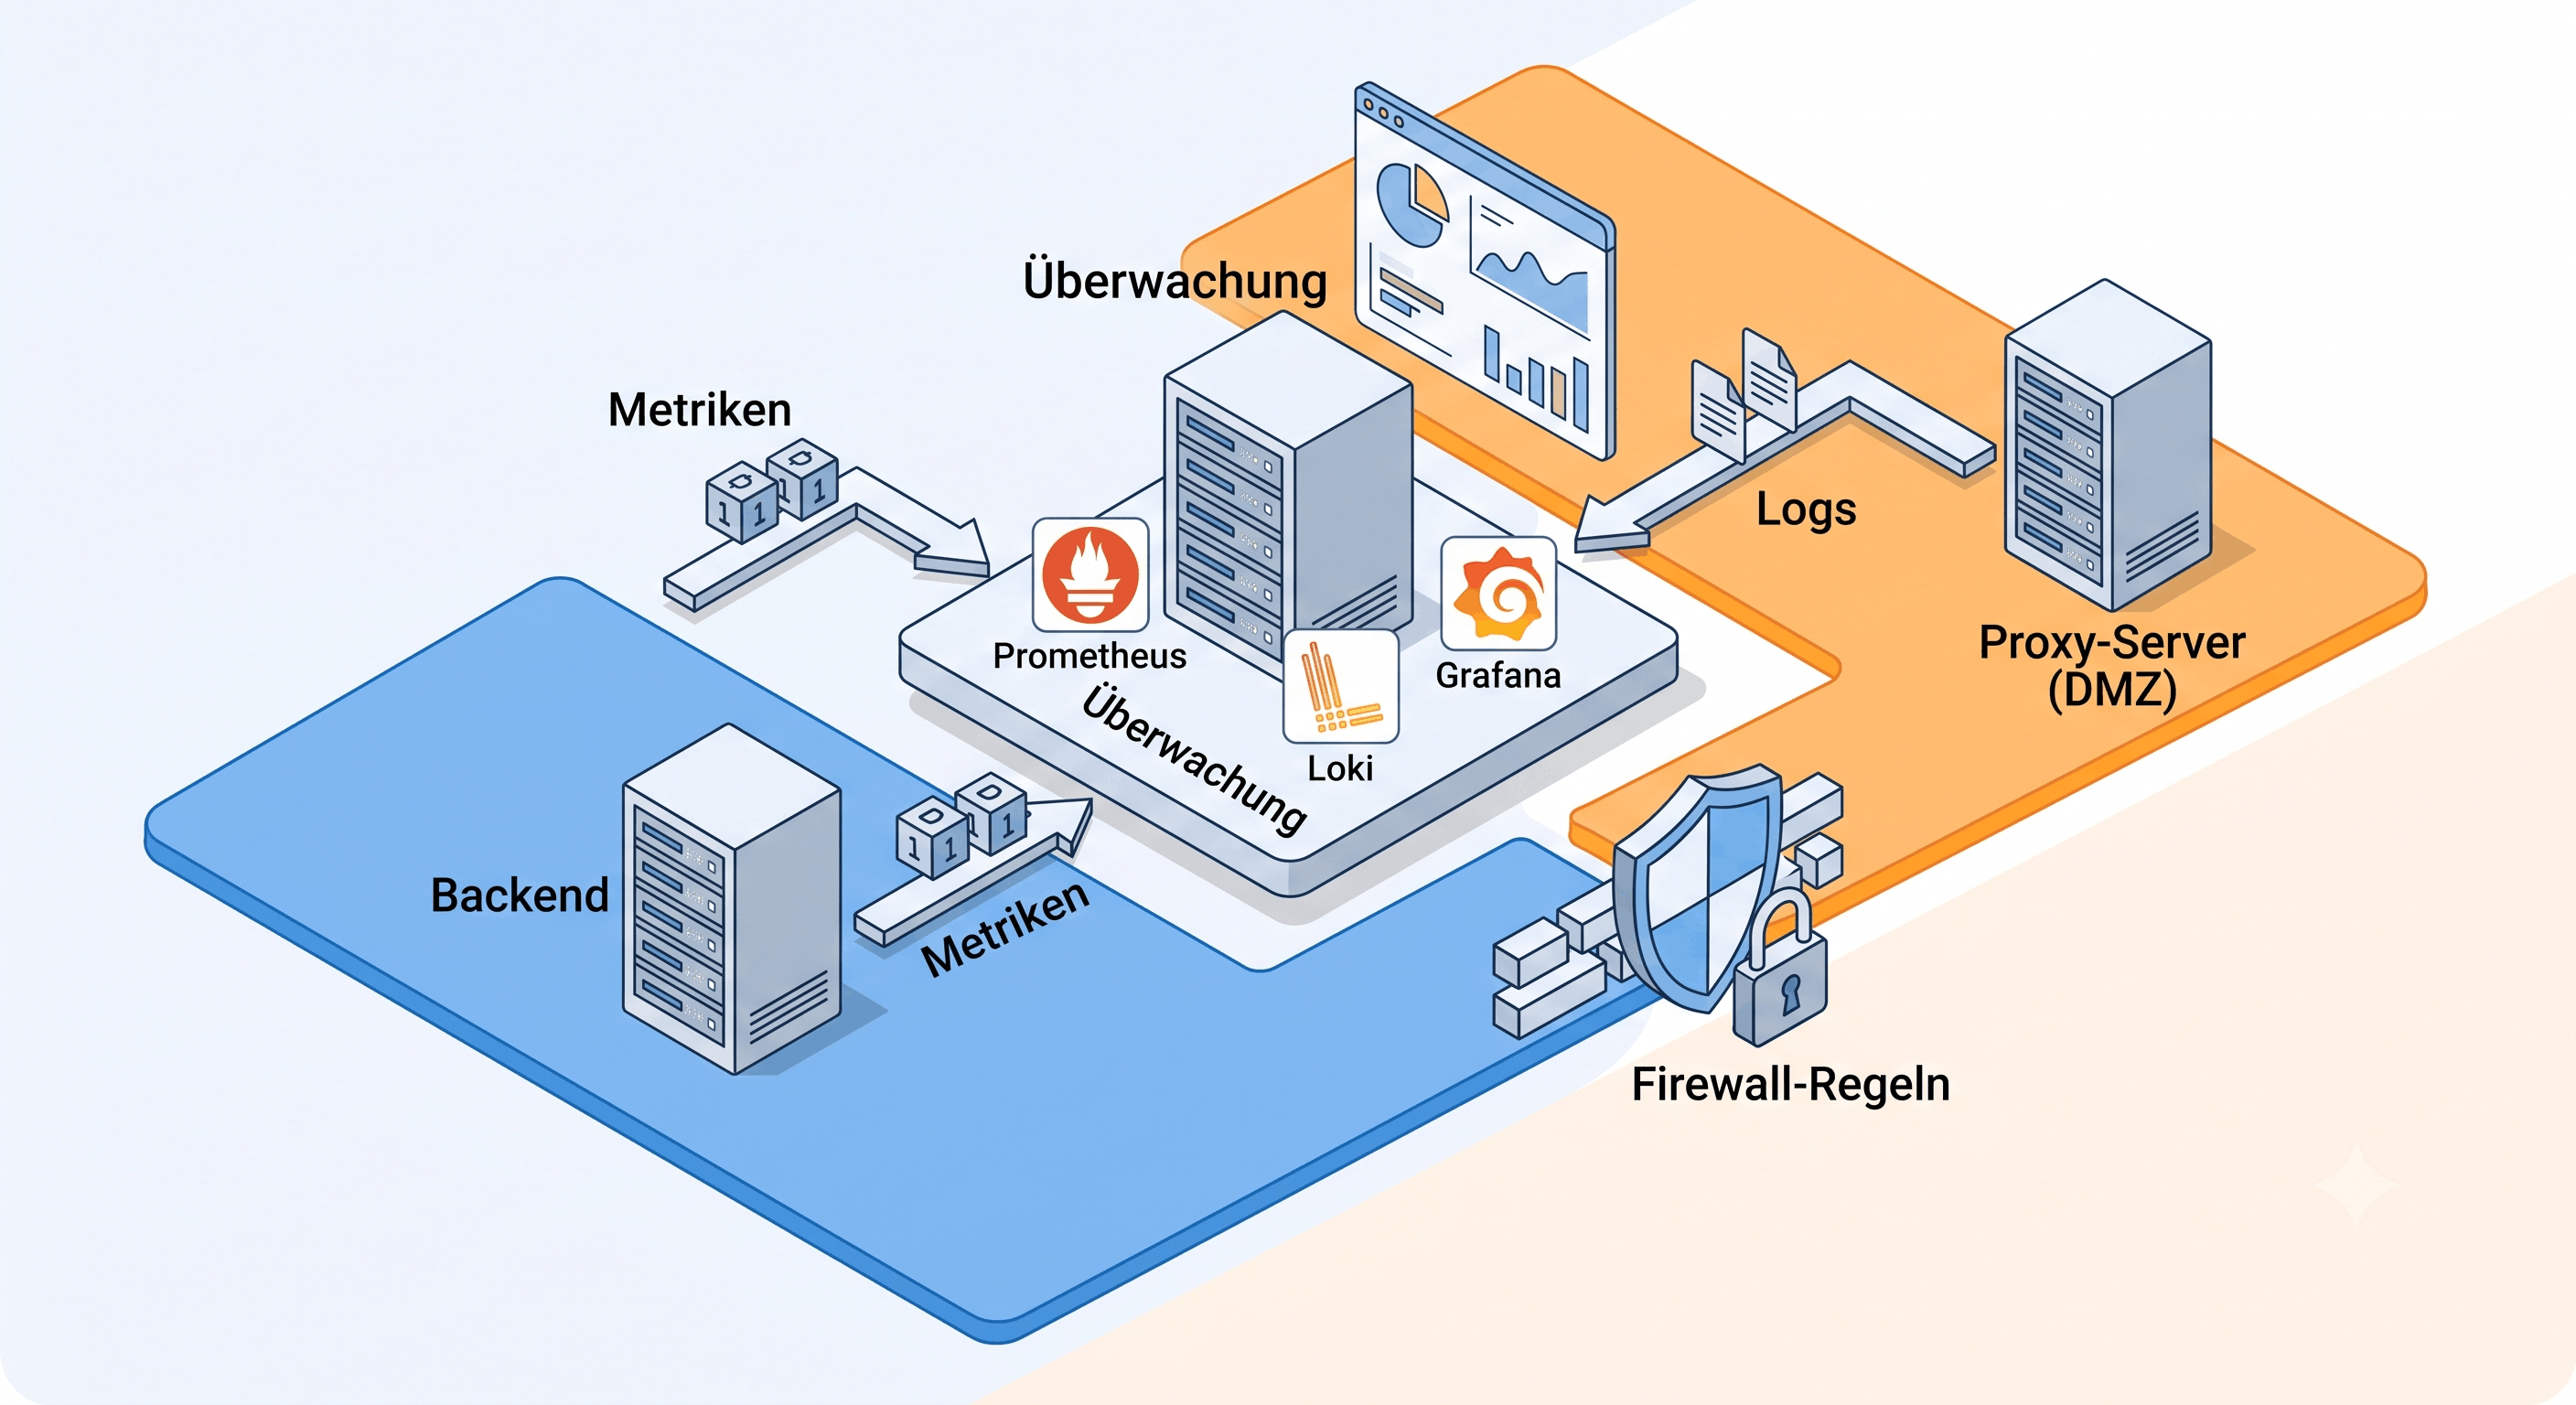
Der Monitoring-Stack lief bislang nur auf dem eigenen Linux-LXC. In dieser Phase wurde er auf zwei weitere Hosts ausgeweitet: den öffentlich erreichbaren Nginx-Proxy und das dahinterliegende App-Backend. Beide laufen in getrennten VLAN-Segmenten, was neben der Monitoring-Konfiguration auch eine gezielte Anpassung der Firewall-Regeln erforderte.
1. Situation (Ausgangslage)
Der Portfolio-Stack (Nginx-Proxy und Flask-Backend) war öffentlich über Cloudflare Tunnel erreichbar, aber komplett ohne Metriken oder Log-Auswertung. Ohne Monitoring blieb unklar ob ein LXC unter Last steht, ob Ressourcen knapp werden oder ob ungewöhnliche Anfragen ankommen. Die beiden Hosts laufen in separaten VLANs (DMZ und Backend), die durch OPNsense segmentiert und standardmässig geblockt sind. Ohne explizite Firewall-Regeln hatte der Monitoring-LXC keinen Zugriff.
2. Task (Zielsetzung)
- Systemmetriken: Node Exporter auf Proxy-LXC und App-Backend installieren und in Prometheus einbinden, sodass CPU, RAM, Disk und Netzwerk beider Hosts überwacht werden.
- Log-Überwachung: Promtail auf dem Proxy-LXC einrichten um Nginx-Zugriffslogs an Loki zu senden, einschliesslich Filterung auf HTTP-Fehler (4xx/5xx).
- Firewall: Minimale, host-spezifische Durchlassregeln in OPNsense anlegen ohne bestehende Segmentierung aufzuweichen.
- Dashboard: Ein neues Grafana-Dashboard mit Host-Dropdown erstellen, das automatisch auf weitere Hosts skaliert.
3. Action (Umsetzung)
A. Node Exporter installieren und verifizieren
Node Exporter wurde auf beiden LXCs aus dem Standard-Debian-Repository installiert. Der Dienst läuft als unprivilegierter Systembenutzer, benötigt keine Datenbank und exponiert Systemmetriken passiv auf Port 9100. Prometheus holt sie aktiv alle 15 Sekunden ab (Pull-Prinzip). Dass der Dienst tatsächlich erreichbar ist und Metriken liefert, wurde auf beiden Hosts mit ss -tlnp und einem direkten curl auf den Metrics-Endpunkt geprüft.
B. Firewall-Regeln in OPNsense
Da OPNsense Firewall-Regeln am eingehenden Interface prüft, braucht jede Verbindung die ein Interface überquert Regeln auf beiden Seiten: am LAN-Interface (wo das Paket vom Monitoring-LXC reinkommt) und am VLAN-Interface (wo es beim Ziel-LXC ankommt). Eine Stateful-Firewall erinnert sich an Verbindungszustände und erlaubt Rückverkehr automatisch, aber das ersetzt keine Regeln auf dem zweiten Interface.
Alle Regeln wurden mit /32-Subnetzmasken angelegt, also für genau eine Quell- und eine Ziel-IP. Nur der Monitoring-LXC darf scrapen, kein anderer Host im LAN. Die neuen Pass-Regeln stehen oberhalb der bestehenden Block-Regeln für die VLAN-Segmente, weil OPNsense nach dem First-Match-Prinzip arbeitet: eine spezifische Ausnahme unterhalb einer allgemeinen Block-Regel wird nie erreicht.
Die Funktion wurde vor und nach dem Anlegen der Regeln mit nc -zv geprüft: vorher "Connection timed out", danach "open". Der OPNsense Live-Log zeigte die passenden Regelanwendungen.
C. Prometheus-Scrape-Config erweitern
Die Prometheus-Konfiguration wurde um zwei neue Scrape-Targets ergänzt. Jedem Target wurde ein lesbares host-Label mitgegeben (z.B. "proxy-DMZ", "app-backend") statt die technische Scrape-Adresse als Label zu verwenden. Das erleichtert die spätere Auswertung in Grafana erheblich. Nach der Änderung wurde die Config mit promtool check config auf Syntaxfehler geprüft und Prometheus per systemctl reload neu geladen, ohne den Prozess zu unterbrechen. Alle drei Targets zeigten danach in der Prometheus-UI den Status "UP".
D. Promtail auf dem Proxy-LXC einrichten
Promtail muss direkt auf dem Host laufen dessen Logs es lesen soll, weil es lokale Dateipfade einliest. Das offizielle Grafana-APT-Repository wurde eingebunden und Promtail installiert. Der Loki-Endpunkt in der Konfiguration zeigt auf die Netzwerk-IP des Monitoring-LXC statt auf localhost, da Loki nicht lokal läuft.
Nginx schreibt Access-Logs mit Gruppenbesitz adm, der Promtail-Benutzer war nicht Mitglied dieser Gruppe. Dieselbe Lösung wie in der vorherigen Phase: usermod -a -G adm promtail. Das -a-Flag ist dabei nicht optional, ohne es werden alle anderen Gruppenmitgliedschaften des Benutzers überschrieben. Die Konfiguration wurde vor dem Start mit promtail -check-syntax validiert.
E. Grafana-Dashboard mit Host-Dropdown
Das neue Dashboard nutzt eine Grafana-Variable vom Typ "Query": label_values(node_uname_info, host) liefert alle bekannten Host-Namen aus Prometheus. Damit erscheint ein neuer Host automatisch im Dropdown sobald er einen Scrape-Job mit host-Label erhält, ohne dass das Dashboard angepasst werden muss. Die Nginx-Log-Panels sind bewusst nicht an die Host-Variable gekoppelt, da Nginx nur auf einem der Hosts läuft.
Ein Fehler in der Uptime-Query ("750 years") entstand weil beim Wechsel vom instance- auf das host-Label die Label-Zuordnung zwischen zwei Metriken nicht mehr funktionierte. Behoben durch Ersetzen von node_time_seconds durch time(), das unabhängig von Labels die aktuelle Prometheus-Zeit liefert.
4. Result (Ergebnis & Verifikation)
Beide Hosts liefern Systemmetriken an Prometheus und erscheinen im Grafana-Dashboard-Dropdown. Nginx-Zugriffslogs werden von Loki empfangen und sind im Dashboard durchsuchbar. Beim ersten Grafana-Explore-Query waren sofort relevante Einträge sichtbar: automatische WordPress-Scanner (Anfragen auf /wp-admin/install.php, von Nginx mit 404 beantwortet), mehrere Web-Crawler sowie echte Besucher. Das zeigt unmittelbar den praktischen Nutzen der Log-Auswertung für einen öffentlich erreichbaren Dienst.
Verifiziert wurde jeder Schritt einzeln: Dienststatus per systemctl, Ports per ss -tlnp, Metrikverfügbarkeit per curl, Firewall-Verhalten per nc -zv und Live-Log, Prometheus-Targets per Web-UI, Loki-Eingang per Label-API.
Lessons Learned
- Stateful bedeutet nicht interface-übergreifend: Eine Stateful-Firewall erinnert sich an Verbindungszustände und spart die Rückrichtungsregel. Sie ersetzt aber keine Regeln auf einem zweiten Interface. Jede VLAN-Grenze braucht Regeln auf beiden Seiten.
- First Match ist keine Theorie: Eine korrekte Pass-Regel die unterhalb einer allgemeinen Block-Regel steht, hat in OPNsense keine Wirkung. Reihenfolge immer prüfen, Baseline-Test (vor und nach der Änderung) macht den Unterschied sichtbar.
- Lesbare Labels von Anfang an: Das
instance-Label in Prometheus enthält die Scrape-Adresse (IP:Port), kein lesbarer Name. Eigenehost-Labels in der Scrape-Config sind von Anfang an sinnvoll, später umzubauen erfordert alle PromQL-Queries anzupassen. - Konfiguration vor Neustart validieren: Sowohl
promtool check configfür Prometheus als auchpromtail -check-syntaxfangen Syntaxfehler ab bevor ein Dienst mit kaputter Config neu startet. Das spart einen unnötigen Ausfall. - Nginx-Logs zeigen sofort was passiert: Schon kurz nach dem ersten Grafana-Query waren Scanner-Anfragen, Crawler und echte Besucher erkennbar. Log-Auswertung lohnt sich auch für kleine, öffentlich erreichbare Dienste.