
Waldemar Schneider
IT-Systemintegrator, der sowohl die Produktionshalle als auch den Serverraum versteht.
© 2026 Waldemar Schneider
 Portfolio
Monitoring-Stack: Grafana, Prometheus & Loki
Inhalt
Projektübersicht
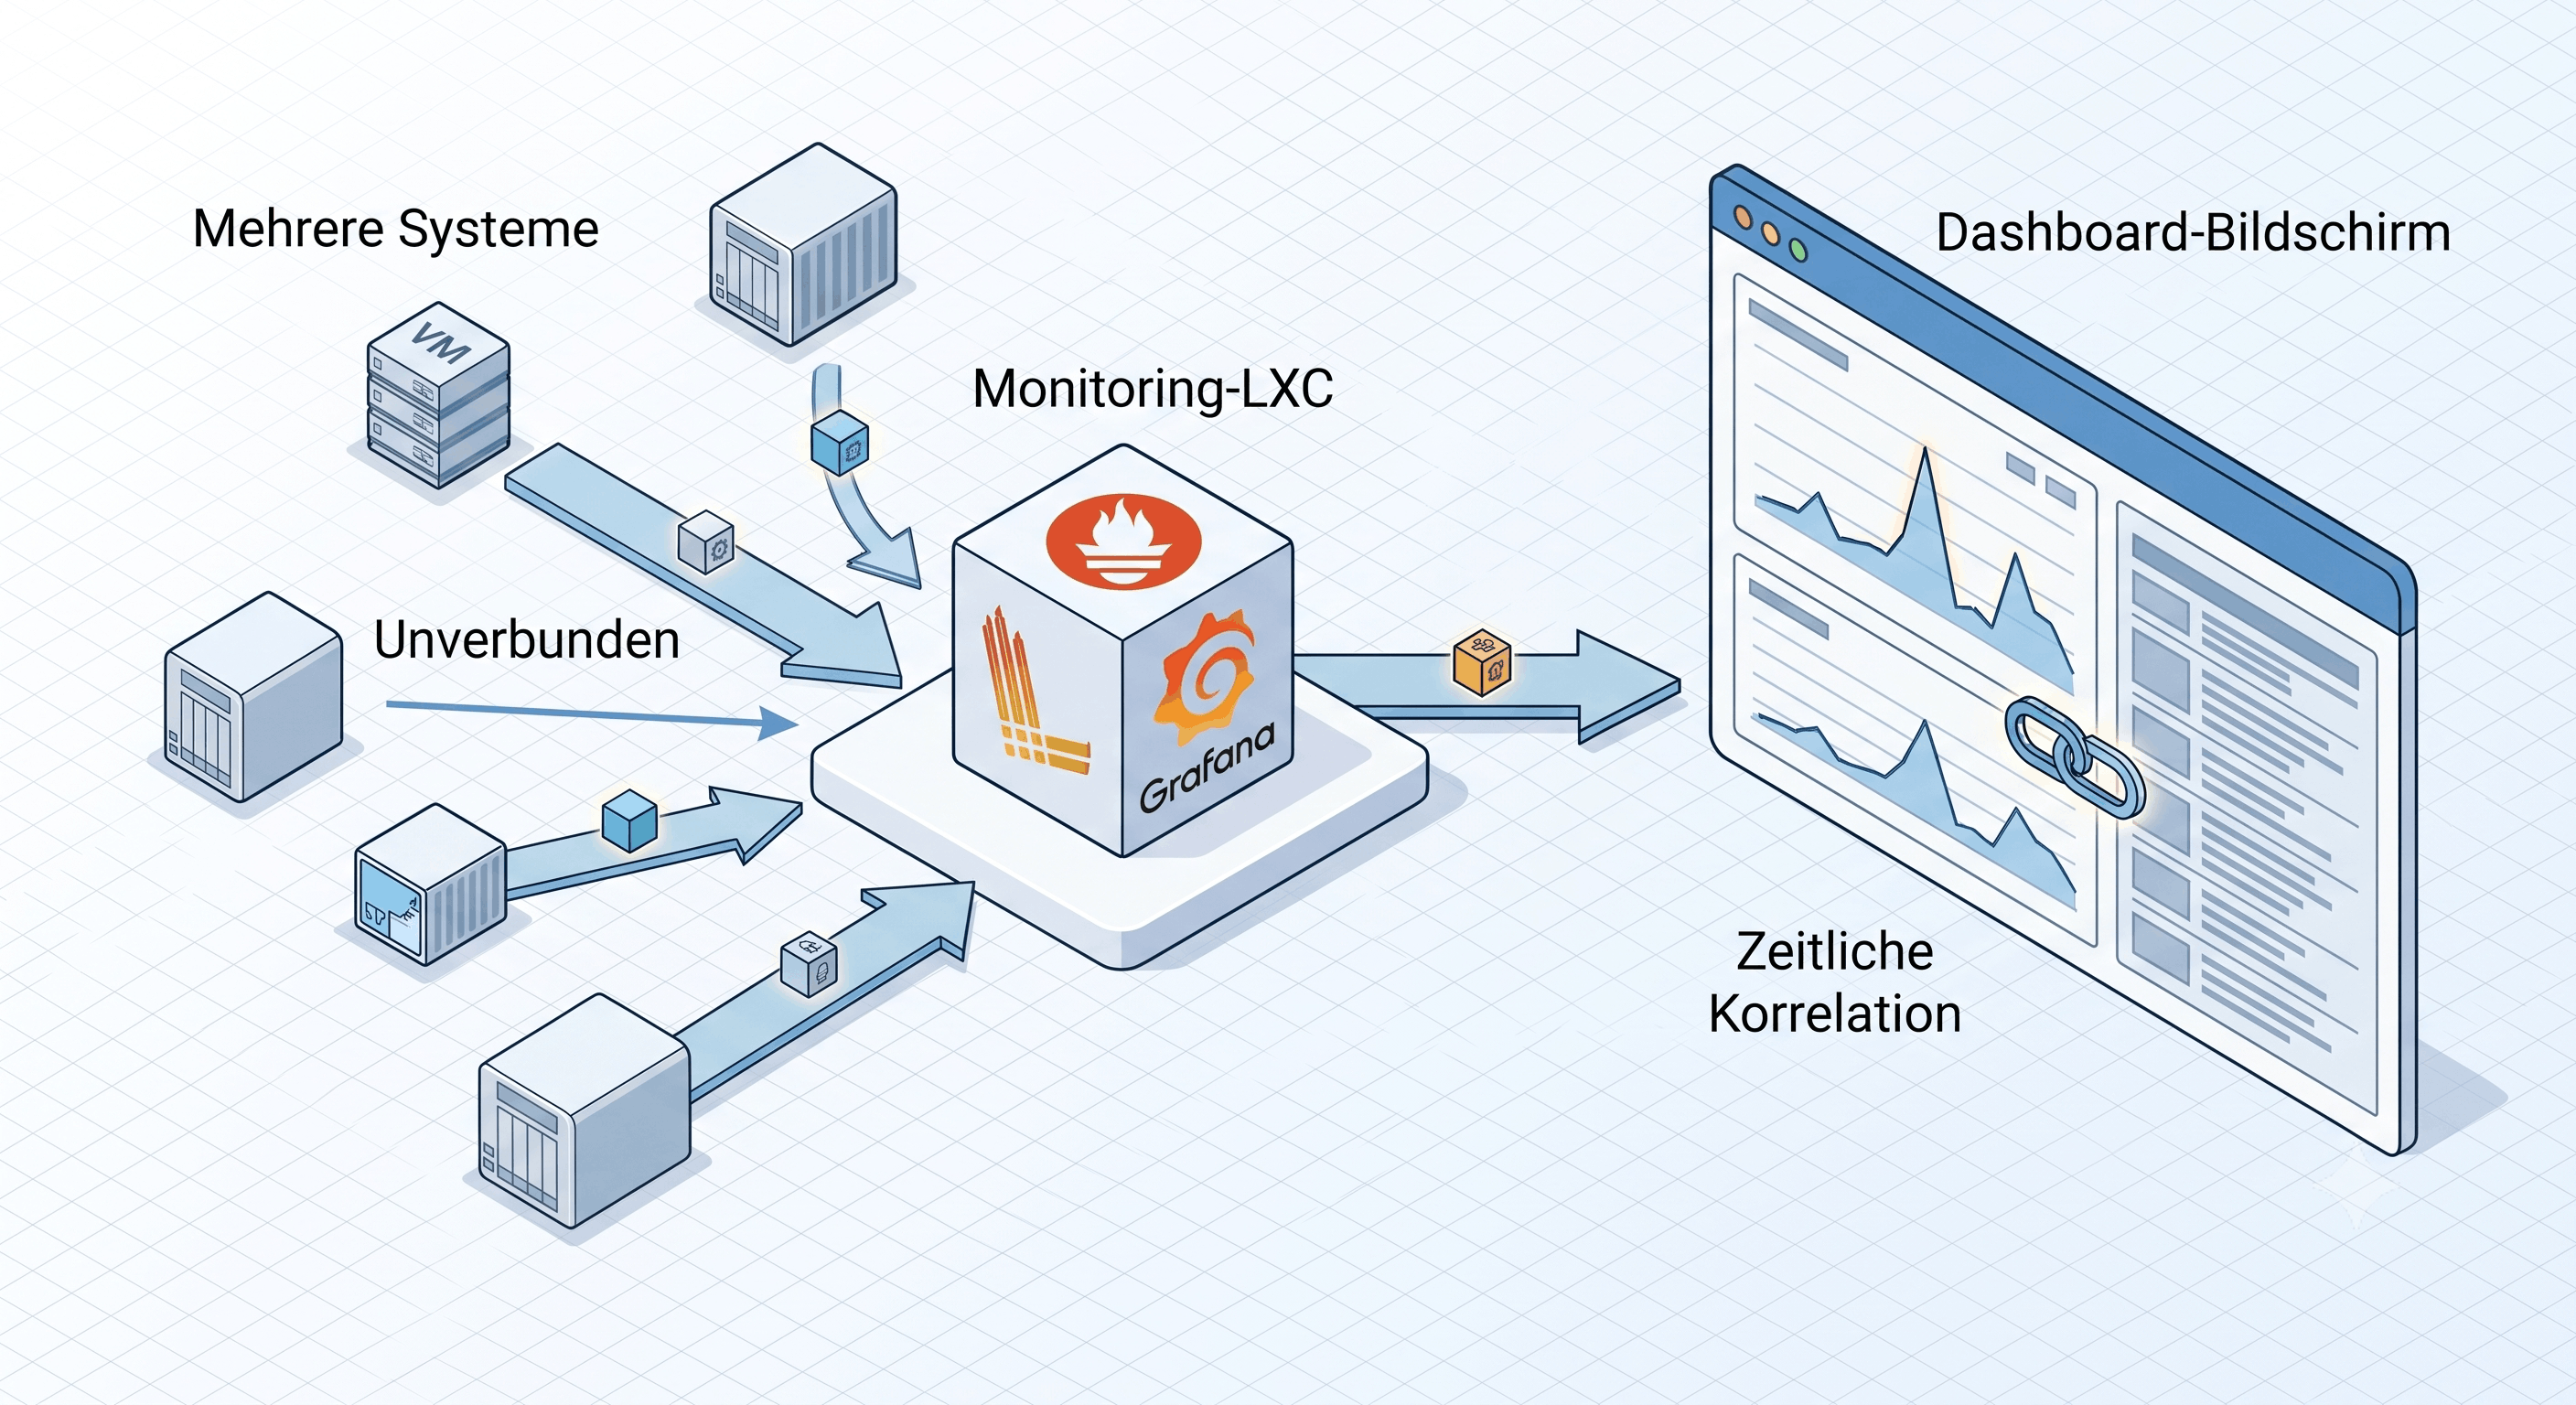
Aufbau eines zentralen Monitoring-Stacks (PLG) auf einem LXC-Container, der Systemmetriken und Logs aus der gesamten Infrastruktur in einer einzigen Grafana-Oberfläche zusammenführt.
1. Situation (Ausgangslage)
Die Heimlabor-Infrastruktur umfasst mehrere VMs und LXC-Container (OPNsense, PBS, Fileserver, Forgejo). Es gab keine zentrale Stelle, um den Zustand der Systeme zu überprüfen. CPU-Auslastung, Speicherverbrauch, Disk-Nutzung und Logs mussten einzeln auf jedem System abgefragt werden. Bei Problemen fehlte die Möglichkeit, Metriken und Logs zeitlich zu korrelieren, z.B. einen CPU-Spike mit dem auslösenden Prozess in den Logs zu verknüpfen.
2. Task (Zielsetzung)
- Zentrale Übersicht: Alle Systemmetriken (CPU, RAM, Disk, Netzwerk) und Logs in einer Oberfläche.
- Korrelation: Metriken und Logs im selben Dashboard mit synchronisiertem Zeitbereich, damit Ursachen sichtbar werden.
- Ressourcenschonend: Der gesamte Stack soll auf einem einzelnen LXC-Container mit 2 GB RAM laufen.
- Industriestandard: Keine Eigenentwicklung, sondern bewährte Open-Source-Werkzeuge die auch in Unternehmen eingesetzt werden.
3. Action (Umsetzung)
A. LXC-Container und Grundinstallation
Einen dedizierten Debian 12 LXC-Container auf Proxmox erstellt:
- 2 GB RAM, 20 GB Disk, unprivilegiert mit Nesting (für systemd).
- Grafana, Loki und Promtail aus dem offiziellen Vendor-Repository (
apt.grafana.com) installiert, nicht aus dem Standard-Debian-Repo. GPG-signierte Pakete, automatische Updates überapt upgrade. - Prometheus und Node Exporter aus dem Debian-Repo installiert (dort aktuell genug).
B. Metriken mit Prometheus (Pull-Prinzip)
Prometheus als Metrik-Backend konfiguriert:
- Node Exporter liefert Systemmetriken (CPU, RAM, Disk, Netzwerk) auf Port 9100.
- Prometheus scraped den Exporter alle 5 Sekunden. Fällt ein System aus, schlägt der Scrape fehl und der Ausfall ist sofort erkennbar.
- Als Default-Datasource in Grafana eingebunden. Erste Verifikation mit
node_cpu_seconds_totalQuery.
C. Logs mit Loki und Promtail (Push-Prinzip)
Loki als Log-Backend und Promtail als Log-Agent konfiguriert:
- Promtail liest
/var/log/syslogund schickt neue Zeilen per Push an Loki. - rsyslog musste zusätzlich installiert werden, weil ein minimales Debian 12 LXC Logs nur ins systemd-Journal im RAM schreibt, nicht auf Disk.
- Standard-Promtail-Konfiguration angepasst: Logpfad von
/var/log/messages(Red Hat) auf/var/log/syslog(Debian) geändert. - Loki indexiert nur Labels, nicht den gesamten Log-Inhalt. Das hält den Ressourcenverbrauch niedrig.
4. Result (Ergebnis & Verifikation)
- Der gesamte PLG-Stack läuft stabil auf einem einzigen LXC-Container unter 2 GB RAM.
- Prometheus-Metriken und Loki-Logs sind als Datasources in Grafana verfügbar und können in gemeinsamen Dashboards kombiniert werden.
- Verifikation abgeschlossen: Prometheus liefert CPU-Metriken aller Modi (idle, system, user, iowait), Loki zeigt Systemlogs mit Zeitstempel und Log-Level.
- Nächster Schritt: Dashboards bauen und weitere Systeme (PVE-Host, OPNsense, Laptop) anbinden.
Lessons Learned
- Debian vs. Red Hat Logpfade:
/var/log/syslog(Debian) vs./var/log/messages(Red Hat). Die Standard-Promtail-Konfiguration geht von Red Hat aus. Auf Debian muss der Pfad angepasst werden. - rsyslog ist nicht selbstverständlich: Ein minimales Debian 12 LXC hat kein rsyslog vorinstalliert. Ohne rsyslog ist
/var/log/syslogleer (0 Bytes) und Promtail hat nichts zu lesen. - Pull vs. Push sind komplementär: Prometheus (Pull) erkennt Ausfälle sofort, Promtail (Push) ist ideal für dateibasierte Logs. Beides läuft in Grafana nahtlos zusammen.
- YAML-Einrückung ist kritisch: Ein einzelnes Leerzeichen zu viel in der Promtail-Konfiguration und der Dienst startet nicht. Bei jeder Änderung
systemctl statusprüfen.